Пользу AI в QA нельзя просто взять и замерить количеством промптов, токенов, запусков агента или сгенерированных тестов. Важен результат, который прошёл проверку и вошёл в работу: сколько времени и денег на него ушло и сохранилось ли качество по сравнению с процессом без AI.
Команда подключает AI к тестированию. Через месяц тест-кейсы готовятся быстрее, причины падений находятся за секунды, запросов стало больше. Но эти цифры ещё не отвечают на главный вопрос: что изменилось в процессе и сколько стоит это улучшение?
«Кажется, стало быстрее» рассыпается, когда пилот нужно обосновать цифрами. Генерация может ускориться, а ревью и исправления — съесть выигрыш. Дешёвый запрос тоже ничего не гарантирует: сотня новых тестов может превратиться в сотню артефактов, которые ещё предстоит проверить. Сам факт активности ничего не доказывает.
В выборке Russia Quality Report 2025–2026 15% компаний уже используют AI в продуктивных QA-процессах, 21% ведут пилоты, 30% изучают сценарии применения. 17% участников пока не получили измеримых результатов. Разрыв виден уже здесь: применение есть, подтверждённый эффект — не у всех.
Поэтому считать нужно изменение самого процесса: время, качество и полную стоимость принятого результата. Для сравнения нужна исходная точка без AI — baseline, затем учитываются ревью и доработки, расходы на модель и инфраструктуру, а уже после этого — TCO и ROI.
Дальше разберём методику на одном сквозном примере — анализе причин падений с помощью AI (AI-assisted failure triage): от результата теста и логов до проверенной классификации и следующего действия.
Почему «кажется, стало быстрее» — недостаточно
Ощущение ускорения полезно как первый сигнал, но само по себе ничего не доказывает. Ответ модели может появиться за секунды, а задача закончится только после проверки, исправлений, повторного запуска и принятого решения.
Это хорошо видно на данных METR за 2026 год. В февральском эксперименте участвовали 57 разработчиков, 143 репозитория и более 800 задач. Полученные оценки ускорения пересекали ноль, а выборка столкнулась со смещением: часть участников не хотела выполнять задачи без AI. При таких условиях точный эффект отделить от особенностей отбора уже нельзя.
В мае 2026 METR опросил 349 технических специалистов. Медианная самооценка прироста создаваемой ценности составила 1,4–2 раза, а оценки ускорения оказались ещё выше. Эти данные не спорят с февральским экспериментом: в одном случае измерялось время выполнения выбранных задач, в другом — собственная оценка работы с AI и её ценности.
Отсюда простой принцип для пилота: сначала определить, что именно должно измениться. Иначе в одном отчёте окажутся рядом задержка модели, количество новых тест-кейсов и субъективно сэкономленное время — три корректные цифры, которые измеряют разные вещи.
На более широкой выборке картина похожая. В World Quality Report 2025–26 средний заявленный прирост продуктивности составляет 19%, но примерно треть участников увидела минимальный эффект, а до масштабирования AI на уровне всей организации дошли 15%. Это результаты опроса, поэтому 19% нельзя превращать в универсальный ориентир для другого процесса или команды.
Отдельная ловушка — расход токенов. DORA разбирает её через понятие tokenmaxxing: большое потребление показывает интенсивность использования AI, но не производительность. Токены помогают считать расход. Пользу приходится искать дальше — в результате, его качестве и стоимости.
Что считать полезным результатом AI в QA
Сначала нужно договориться, где заканчивается задача. В анализе падений ответ вроде «похоже на проблему окружения» ещё ничего не решает. Результатом становится классификация, которую проверили и после которой появилось конкретное действие: завести дефект, связать падение с известной проблемой, отправить нестабильный тест в карантин, исправить автотест или повторить запуск.
До этого есть только ответ модели.
В других сценариях граница проходит по-разному:
До этого есть только ответ модели.
В других сценариях граница проходит по-разному:
Количество созданных артефактов поэтому мало говорит о качестве работы. Особенно хорошо это видно на автотестах.
В работе ICSE 2026 LLM-сгенерированные тесты для четырёх СУБД оказались немного более склонны к нестабильности, чем исходные наборы. Среди 115 вручную разобранных flaky-тестов 72 — 63% — зависели от порядка элементов, который система не гарантировала.
SWE-Mutation проверяет другой слой качества: способен ли сгенерированный набор тестов отличить корректную реализацию от намеренно изменённой. Бенчмарк включает 2636 мутаций для 800 задач и тем самым оценивает не объём генерации, а способность тестов отсеивать ошибочный код.
Поэтому количество созданных тестов остаётся метрикой производства. Для оценки пользы нужны устойчивость, способность находить ошибки и стоимость результата после проверки.
Шесть слоёв измерения эффективности AI
Одной итоговой цифры для AI-пилота недостаточно. Результат приходится разбирать по шести слоям: время, объём ручной доработки, качество, стоимость, расход ресурсов модели и эффект для всего процесса. Только вместе они показывают, где появилось реальное улучшение, а где работа просто переместилась на другой этап.
Ручные трудозатраты и полная длительность процесса по времени
Самая частая ошибка — измерить только скорость ответа модели. Для этого процесса важнее такие два времени.
- Ручное время работы (human touch time) включает всё, что требует участия человека: подготовку контекста, промпт, проверку, исправления, обработку повторных попыток и ручное завершение.
- Полная длительность (elapsed time) считается от начала задачи до её завершения. Сюда уже входят очередь, задержка модели и инструментов, ожидание между этапами и повторные вызовы.
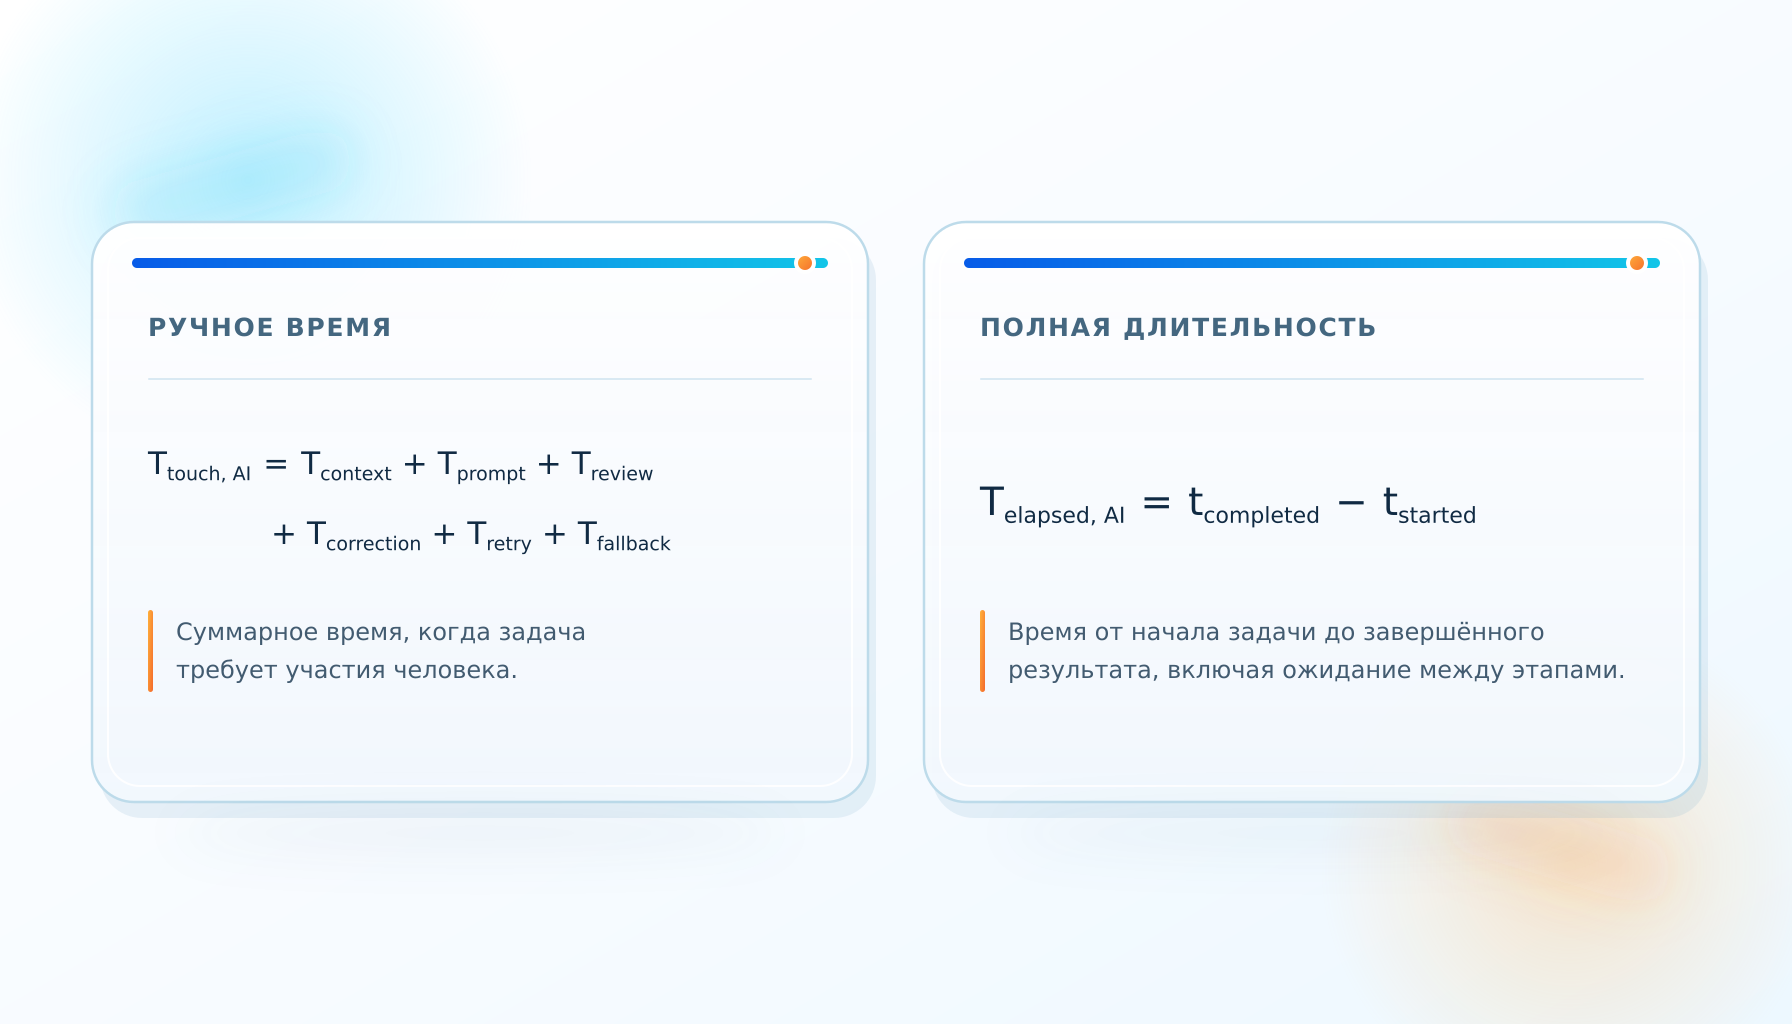
Ожидание ответа модели нельзя автоматически записывать в ручные трудозатраты: пока агент работает, другая работа может продолжаться. Поэтому экономию по этим двум шкалам тоже считают отдельно.
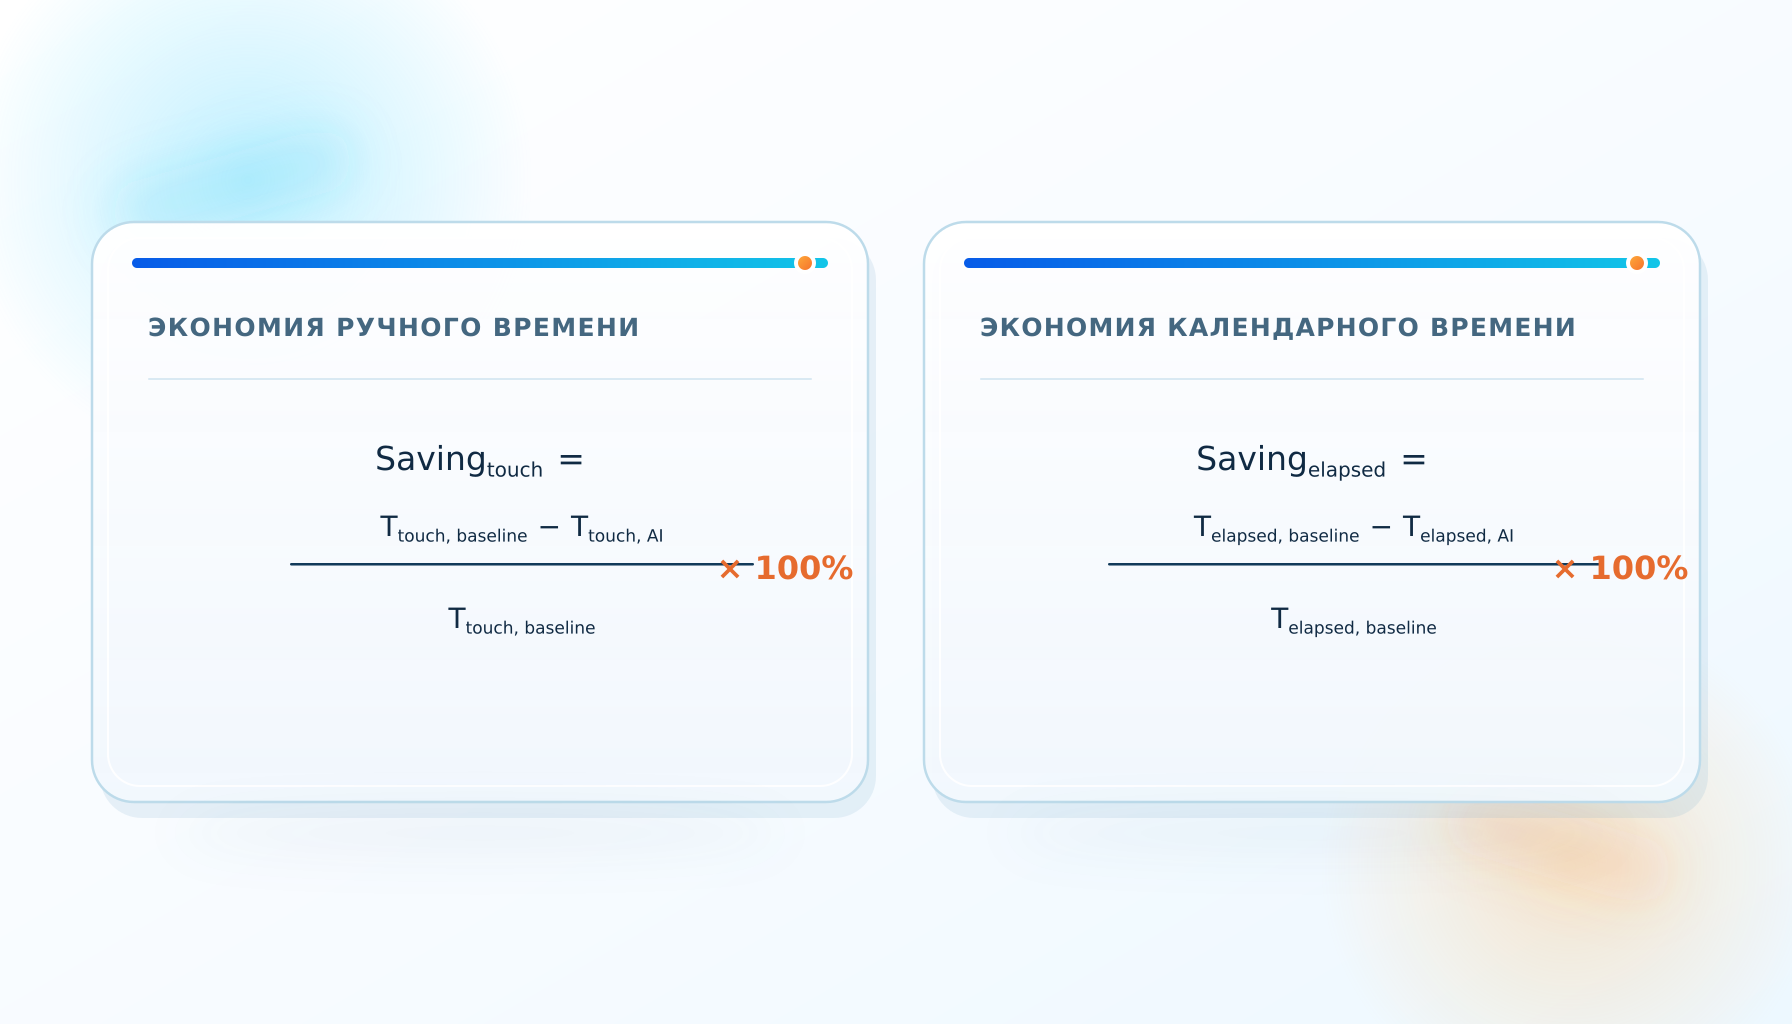
Эти показатели могут двигаться в разные стороны. Если агент выполняет задачу пять минут без участия человека вместо двух минут ручной работы, трудозатраты снижаются, но цикл обратной связи становится длиннее.
Одного среднего тоже недостаточно. P50 показывает типичный случай, P90 или P95 — дорогой хвост распределения, а среднее арифметическое нужно для расчёта общего времени и стоимости за период.
Одного среднего тоже недостаточно. P50 показывает типичный случай, P90 или P95 — дорогой хвост распределения, а среднее арифметическое нужно для расчёта общего времени и стоимости за период.
Ревью и доработка: сколько работы остаётся после AI
Ускорение генерации легко потерять на проверке. В DORA 2026 этот эффект описан как verification overhead: часть времени, выигранного при создании результата, возвращается на аудит, уточнение промпта и исправления.
Чтобы эта работа не исчезала из статистики, достаточно трёх показателей.
Чтобы эта работа не исчезала из статистики, достаточно трёх показателей.
First-pass acceptance показывает, какая доля результатов проходит проверку без существенной переделки. Major rework rate — насколько часто результат приходится серьёзно исправлять. Verified yield связывает всё это с исходным потоком задач, а не только с той частью, которую AI сумел обработать.
Например, 95% успешных разборов ещё не означают 95% эффективности всего потока. Если половина подходящих задач заканчивается ручным fallback, это должно остаться в знаменателе.
Например, 95% успешных разборов ещё не означают 95% эффективности всего потока. Если половина подходящих задач заканчивается ручным fallback, это должно остаться в знаменателе.
Мерить только "accuracy" для triage недостаточно
Эта метрика показывает долю всех правильных классификаций, но при несбалансированных классах легко скрывает слабое место. Большой простой класс способен поднять общий процент даже тогда, когда редкие продуктовые дефекты распознаются плохо.
Для анализа падений полезнее смотреть на несколько показателей:
• precision — какая доля предсказаний выбранного класса оказалась правильной;
• recall — какая доля реальных случаев этого класса была найдена;
• macro-F1 — насколько сбалансирован результат между классами разного размера;
• recall критических продуктовых дефектов — отдельно для ошибок с высокой ценой пропуска;
• abstention rate — как часто модель отказывается от классификации и передаёт задачу на ручную проверку;
• human correction rate и re-triage rate — как часто первоначальное решение приходится исправлять или пересматривать.
В кейсе Т-Банка accuracy используется как первая метрика бенчмарка. Для красной категории получено 87%, однако одного общего процента недостаточно: ложное срабатывание и пропущенный дефект имеют разную цену. Поэтому следующий этап оценки включает precision и recall.
Порог качества фиксируют до пилота. Его задача — не дать ускорению скрыть неприемлемый рост ошибок.
И человеческая приёмка не всегда становится окончательной истиной. Сегодня падение можно классифицировать как проблему окружения, а позже найти продуктовую причину. Поэтому ранние решения периодически сверяют с финальной причиной сбоя, повторными запусками, связанными дефектами и последующими инцидентами.
Сколько стоит принятый результат
Цена запроса к модели здесь вторична. В расчёт входит весь дополнительный контур: модель и инструменты, инфраструктура, лицензии, интеграция, безопасность и ручная работа от подготовки контекста до fallback.
Если ручное время уже посчитано целиком, отдельно добавлять review и rework в стоимость нельзя — иначе одна и та же работа попадёт в формулу дважды.
Если ручное время уже посчитано целиком, отдельно добавлять review и rework в стоимость нельзя — иначе одна и та же работа попадёт в формулу дважды.
Так дешёвая модель перестаёт выглядеть выгодной автоматически. Если её ответы требуют больше исправлений, итоговая стоимость принятого результата может оказаться выше.
Как модель производит затраты токенов на принятый результат
Расход токенов полезен для диагностики, но не является самостоятельной метрикой пользы. Внутри одного сценария удобнее считать, сколько оплачиваемых токенов приходится на результат, который прошёл проверку.
Сравнивать этот показатель корректно прежде всего внутри одного сценария и сопоставимой конфигурации. У разных моделей и провайдеров отличаются токенизаторы, кеширование и правила тарификации инструментов.
Поэтому для экономического сравнения надёжнее смотреть не на количество токенов, а на деньги, ушедшие на проверенный и принятый результат.
Поэтому для экономического сравнения надёжнее смотреть не на количество токенов, а на деньги, ушедшие на проверенный и принятый результат.
Бизнес-эффект: высвобождённое время ещё не экономия
AI может освободить 100 часов в месяц, но само по себе это не делает компанию богаче. Сначала появляется высвобождённая мощность — capacity gain: прежний объём работы требует меньше человеческого времени.
Финансовый эффект начинается дальше. Если дополнительная мощность позволила обойтись без найма, аутсорса или сверхурочной работы, возникает предотвращённый расход — cost avoidance. Если фактические затраты компании уменьшились, это уже cash saving.
Если освободившиеся часы просто распределились между другими задачами, экономический эффект ещё не реализован. Поэтому ROI считают только по выгоде, которую удалось связать с реальным изменением расходов или другого измеримого бизнес-результата.
Сэкономленные часы в числитель не попадают автоматически. Сначала нужно показать, во что они превратились: предотвращённые расходы, снижение текущих затрат, дополнительный объём работы или другой результат, которому можно присвоить денежную стоимость.
Метрики активности не заменяют метрики результата
Запросы, запуски агента, задержка ответа и токены полезны для диагностики. Ошибка начинается, когда ими пытаются доказать эффективность всего процесса.
Короткая проверка выглядит так:
Короткая проверка выглядит так:
Чем ближе показатель к проверенному результату и его стоимости, тем меньше риск принять активность системы за полезный эффект.